 Lento Quem?
TTFB: o que é e como saber se o servidor está lento
O tempo até o primeiro byte é a medida mais mal interpretada do desempenho web. Entenda o que ele realmente contém e como separar a parte que é rede da parte que é servidor.
TTFB é a sigla de Time To First Byte: o tempo entre o navegador pedir uma página e o primeiro byte da resposta chegar. É a métrica que aparece em toda ferramenta de análise, é citada em toda reunião sobre desempenho — e é, provavelmente, a mais mal interpretada de todas.
O motivo é simples: quase todo mundo trata o TTFB como se fosse a medida da lentidão do servidor. Ele não é. É a soma de várias coisas, e só uma delas é o servidor.
O que está dentro do TTFB
Quando o navegador pede uma página, este é o caminho até o primeiro byte voltar:
- DNS — traduzir o nome do site em endereço IP. Costuma levar de 0 a 100 ms, e some depois da primeira vez graças ao cache.
- Conexão TCP — o aperto de mão inicial. Custa uma ida e volta completa.
- Negociação TLS — estabelecer a criptografia do HTTPS. Mais uma ou duas idas e voltas, dependendo da versão.
- Envio do pedido — mais uma viagem até o servidor.
- Processamento no servidor — aqui, e só aqui, é o backend trabalhando: consultando banco, aplicando regra, montando HTML.
- Volta do primeiro byte — a viagem de retorno.
Repare que cinco dos seis itens são rede. Se você está a 200 ms de distância do servidor, só as viagens já custam bem mais de meio segundo antes de o backend ter escrito uma linha sequer.
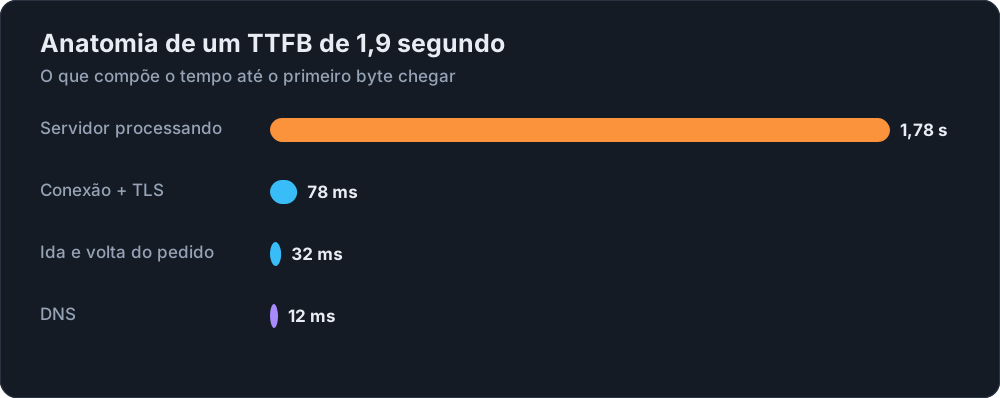
No exemplo acima, o TTFB total foi de 1,9 segundo e o culpado é claríssimo: 1,78 s de processamento. Mas trocar os números muda completamente a conclusão. Se fossem 1,7 s de conexão e 200 ms de processamento, seria a mesma medida de TTFB acusando um culpado totalmente diferente.
Por que o número sozinho não acusa ninguém
Considere dois cenários com TTFB idêntico de 700 ms:
| Cenário A | Cenário B | |
|---|---|---|
| Ida e volta de rede | 650 ms | 60 ms |
| Processamento do servidor | 50 ms | 640 ms |
| Diagnóstico | Servidor ótimo, hospedado longe | Servidor lento, hospedado perto |
| Solução | CDN ou mudar a hospedagem | Otimizar consulta ao banco |
Mesmo TTFB, problemas opostos, soluções opostas. Quem olha só o número gasta semanas otimizando a coisa errada.
Como separar rede de servidor
Existe um método simples e confiável: comparar o TTFB de dois pedidos ao mesmo servidor, um dinâmico e um estático.
Um arquivo estático — uma imagem, um CSS, um JavaScript — já está pronto no disco. O servidor não consulta banco nem executa regra: ele só entrega. O TTFB desse arquivo é, portanto, praticamente só a ida e volta de rede.
A página dinâmica passa pelo mesmo caminho de rede, mas soma o processamento. Logo:
processamento do servidor ≈ TTFB da página − TTFB do arquivo estático
Se o CSS volta em 45 ms e a página em 890 ms, o backend gastou cerca de 845 ms. Se ambos voltam em 600 ms, o backend está saudável e o problema é distância. É esse cálculo que a extensão Lento Quem? faz automaticamente, repetindo cada medição algumas vezes e comparando as medianas para não se enganar com uma variação isolada.
Um cuidado ao aplicar
O método assume que os dois pedidos percorrem o mesmo caminho. Isso deixa de valer quando o site está atrás de CDN e os arquivos estáticos são servidos do cache da borda, enquanto o HTML dinâmico vai até a origem. Nesse caso, a diferença que você calcula inclui a viagem até a origem, e o servidor parece pior do que é.
Dá para desconfiar disso quando os tempos dos arquivos estáticos variam muito entre si: alguns em 20 ms (cache da borda) e outros em 200 ms (origem). Quando isso aparece, o número de processamento vira estimativa, não medida — e uma ferramenta honesta avisa em vez de fingir precisão.
O que faz um TTFB ficar alto
Do lado do servidor
- Consulta lenta ao banco — a causa mais comum. Falta de índice, junção pesada, relatório varrendo tabela inteira.
- Chamada externa sem timeout — a página espera uma API de terceiro que está lenta. Um serviço de frete demorando 3 s trava a tela inteira.
- Ausência de cache — recalcular a cada visita algo que muda uma vez por dia.
- Servidor que hiberna — comum em nuvem barata: o processo dorme quando ninguém acessa e a primeira visita paga o tempo de subir.
- Fila de requisições — em horário de pico, o pedido espera um processo livre antes de começar a ser atendido.
Do lado da rede
- Distância física — a luz na fibra faz uns 200 km por milissegundo. São Paulo–Virgínia não sai por menos de 120 ms de ida e volta, por melhor que seja tudo.
- Rota ruim — tráfego que sai do Brasil, passa por Miami e volta, quando poderia ficar local.
- Ausência de CDN — todo visitante vai até a origem, mesmo para conteúdo que poderia ser servido perto dele.
- TLS mal configurado — versão antiga, sem retomada de sessão, cadeia de certificados longa demais.
Como reduzir cada parte
Reduzindo o processamento
A ordem que costuma render mais: primeiro, descubra qual consulta demora — quase sempre há uma dominando. Depois, cache de página inteira para conteúdo que não é personalizado, que é a mudança de maior impacto e menor custo. Em seguida, índices no banco. Por último, otimizações de código, que normalmente rendem menos do que se imagina.
Reduzindo a rede
Uma CDN resolve boa parte, e não só para arquivo estático: várias delas terminam a conexão TLS perto do usuário e reaproveitam uma conexão já aberta até a origem, o que elimina idas e voltas mesmo em conteúdo dinâmico. Habilitar HTTP/2 ou HTTP/3 também ajuda, especialmente em rede com perda de pacotes.
TTFB e o Google
O TTFB não é uma métrica de Core Web Vitals. Mas ele é o piso de todas as outras: nada pode ser pintado antes do primeiro byte chegar. Um TTFB de 1,5 s garante um LCP acima de 1,5 s, por melhor que seja o resto.
As referências que o Google usa: bom até 800 ms, a melhorar entre 800 ms e 1,8 s, ruim acima disso. Só que esses valores incluem a rede do visitante, que você não controla. Para julgar o seu trabalho, use o processamento isolado — e mire abaixo de 200 ms.
Medindo no dia a dia
No navegador, F12 → aba Rede → clique no documento principal → seção de tempos. O campo "Waiting (TTFB)" mostra o valor. Compare com o de um arquivo CSS e você tem a separação.
Uma armadilha frequente: medir com o cache ligado. O navegador responde do disco, o TTFB aparece como 1 ms e você conclui que está tudo ótimo. Marque "Disable cache" antes de tirar conclusões, ou use janela anônima.
Outra: medir uma vez só. TTFB varia bastante entre pedidos, especialmente com servidor que hiberna ou banco com cache quente. Meça três vezes e use a mediana. Um valor isolado alto pode ser azar; três valores altos são um padrão.
Quem paga a conta de um TTFB alto
Vale entender o custo real antes de decidir quanto investir na correção, porque ele é maior do que a soma dos milissegundos.
Para o usuário interno, o efeito é multiplicativo. Um operador que abre cem telas por dia, cada uma com um segundo a mais de espera, perde quase dois minutos diários só esperando. Parece pouco até multiplicar por vinte pessoas e vinte dias úteis: são treze horas de trabalho por mês evaporando em barra de carregamento. Pior que o tempo é o efeito na atenção — cada espera de mais de um segundo quebra o fluxo de quem está trabalhando, e retomar custa mais do que o segundo perdido.
Para o visitante de um site público, o efeito é abandono. As pessoas desistem de páginas que demoram, e a desistência começa bem antes do que a intuição sugere. Como o TTFB é o piso de tudo, um backend lento significa que nem a otimização mais caprichada de imagens vai salvar a experiência.
Para o buscador, o efeito é indireto porém real. O Google rastreia com orçamento limitado: quanto mais lento cada resposta, menos páginas ele visita na mesma janela. Em site grande, TTFB alto atrasa a descoberta de conteúdo novo.
Um roteiro de investigação que funciona
Quando o TTFB está alto e você não sabe por onde começar, esta sequência costuma achar o culpado rápido, do mais barato para o mais caro de verificar.
Primeiro, confirme que é o servidor. Compare com o tempo de um arquivo estático, como descrito acima. Se a diferença for pequena, pare: o problema é rede e você economizou uma semana de investigação no backend.
Depois, verifique se é constante ou intermitente. Meça dez vezes seguidas. Tempo alto sempre indica algo estrutural — uma consulta pesada em toda requisição. Tempo alto só às vezes indica concorrência, fila ou cache frio, e a investigação muda completamente de direção.
Compare uma página simples com uma pesada. Se a página de login responde em 80 ms e o relatório em 4 s, o problema é específico daquela consulta. Se tudo responde igualmente devagar, inclusive a página mais boba, o problema é de infraestrutura ou de algo executado em toda requisição — um middleware, uma verificação de sessão, uma chamada externa.
Olhe o log do banco. Praticamente todo banco tem registro de consultas lentas. Em nove de cada dez casos de backend lento, existe uma consulta dominante ali, e ela costuma ser resolvida com um índice.
O caso do servidor que dorme
Existe um padrão de TTFB que confunde muita gente e vale conhecer em detalhe, porque ficou comum com a popularização de hospedagem em nuvem barata.
Vários serviços desligam o processo da aplicação quando ninguém acessa por alguns minutos. É uma forma legítima de economizar recursos: se o site não tem visita, não faz sentido manter um processo consumindo memória. O problema é que a próxima visita precisa esperar o processo subir de novo — carregar o runtime, abrir conexão com o banco, aquecer os caches.
O resultado é um TTFB de 2 a 5 segundos para o primeiro visitante, e 150 ms para todos os seguintes. Se você medir na hora errada, chega a conclusões opostas sobre o mesmo servidor.
Como reconhecer: meça o TTFB, espere, e meça de novo imediatamente. Se a primeira medição foi muito alta e as seguintes são baixas, é hibernação. A confirmação definitiva vem de esperar dez minutos sem acessar e medir novamente — se o tempo alto voltar, está confirmado.
Isso importa porque o usuário real vive a primeira medição, não a segunda. Quem chega de manhã e abre o sistema é exatamente a pessoa que paga o preço de subir o processo. Dizer que "o servidor responde em 150 ms" com base na segunda medição é enganar a si mesmo. Uma medição honesta reporta os dois números e explica a diferença.
TTFB em rede com perda de pacotes
Um efeito pouco discutido: perda de pacotes inflaciona o TTFB de forma desproporcional. Se o pacote que carrega o seu pedido se perde, o TCP só percebe depois de um tempo de espera e retransmite. Esse tempo de espera inicial é da ordem de centenas de milissegundos a um segundo, dependendo da pilha.
Ou seja: uma perda de 2% não atrasa 2% dos pedidos em 2%. Ela atrasa 2% dos pedidos em um segundo inteiro. Como o navegador precisa de dezenas de recursos para montar a página, a chance de pelo menos um deles pegar uma retransmissão é alta, e o carregamento inteiro trava esperando aquele único recurso.
Por isso um TTFB que varia muito entre medições — 80 ms, 90 ms, 1.100 ms, 85 ms — costuma indicar perda de pacotes em algum ponto do caminho, e não servidor instável. A assinatura é a mesma: valores baixos e consistentes, com saltos ocasionais para a casa do segundo.
O resumo que vale levar
TTFB é uma boa métrica desde que você lembre do que ele contém. Sozinho, ele diz que houve espera — não diz de quem foi a culpa. A pergunta útil nunca é "meu TTFB está alto?", e sim "quanto do meu TTFB é distância e quanto é o meu código?". Quem responde essa segunda pergunta sabe exatamente onde mexer; quem fica na primeira otimiza no escuro.
Perguntas frequentes
Qual é um bom valor de TTFB?
O Google considera bom abaixo de 800 ms e ruim acima de 1,8 s. Mas esse número inclui a rede: o que realmente indica saúde do backend é o tempo de processamento isolado, que deveria ficar abaixo de 200 ms.
TTFB alto sempre significa servidor lento?
Não. Um TTFB de 600 ms pode ser um servidor rápido do outro lado do mundo, ou um servidor lento ao lado de casa. Sem separar a ida e volta de rede do processamento, o número sozinho não acusa ninguém.
TTFB afeta o ranqueamento no Google?
Indiretamente. O TTFB não é uma métrica de Core Web Vitals, mas atrasa tudo que vem depois — inclusive o LCP, que é. Cada milissegundo no TTFB é um milissegundo somado a todas as métricas seguintes.
Continue lendo
 Rede
Perda de pacotes: o vilão invisível que trava sua internet
Sua internet marca boa velocidade, mas vídeos travam, chamadas cortam e jogos dão teleporte?…
 Diagnóstico
O site caiu ou é a minha internet? Como descobrir em 1 minuto
Aquele site não abre e você não sabe se ele saiu do ar ou se o problema é seu. Veja um rotei…
 Diagnóstico
Emissor de NF-e lento: é a internet, o sistema ou a SEFAZ?
A nota fiscal demora a autorizar e a fila só cresce. O problema pode estar em três lugares b…